Voilà il fallait le faire depuis bien longtemps mais je n'avais jamais pris le temps de migrer les quelques blogs que je me suis résigné à ne pas effacer... Certes je d'accord avec vous on parle plus d'une sauvegarde de données mais bon c'était mes débuts sur internet...
Donc depuis quelques temps je me bats avec des installations wordpress qui sont certes à jours mais qui sont quand même des cibles faciles pour les pirates car il y a des vieux plugins qui ne sont plus maintenus par les développeurs et qui sont des portes ouvertes pour les pirates. Mes anciens blogs (2803, blog4auto, blogdecodesign) étaient donc devenus des portes ouvertes pour diffuser du contenu et des redirections vers des sites chelous et cela commençait à m'énerver fortement.
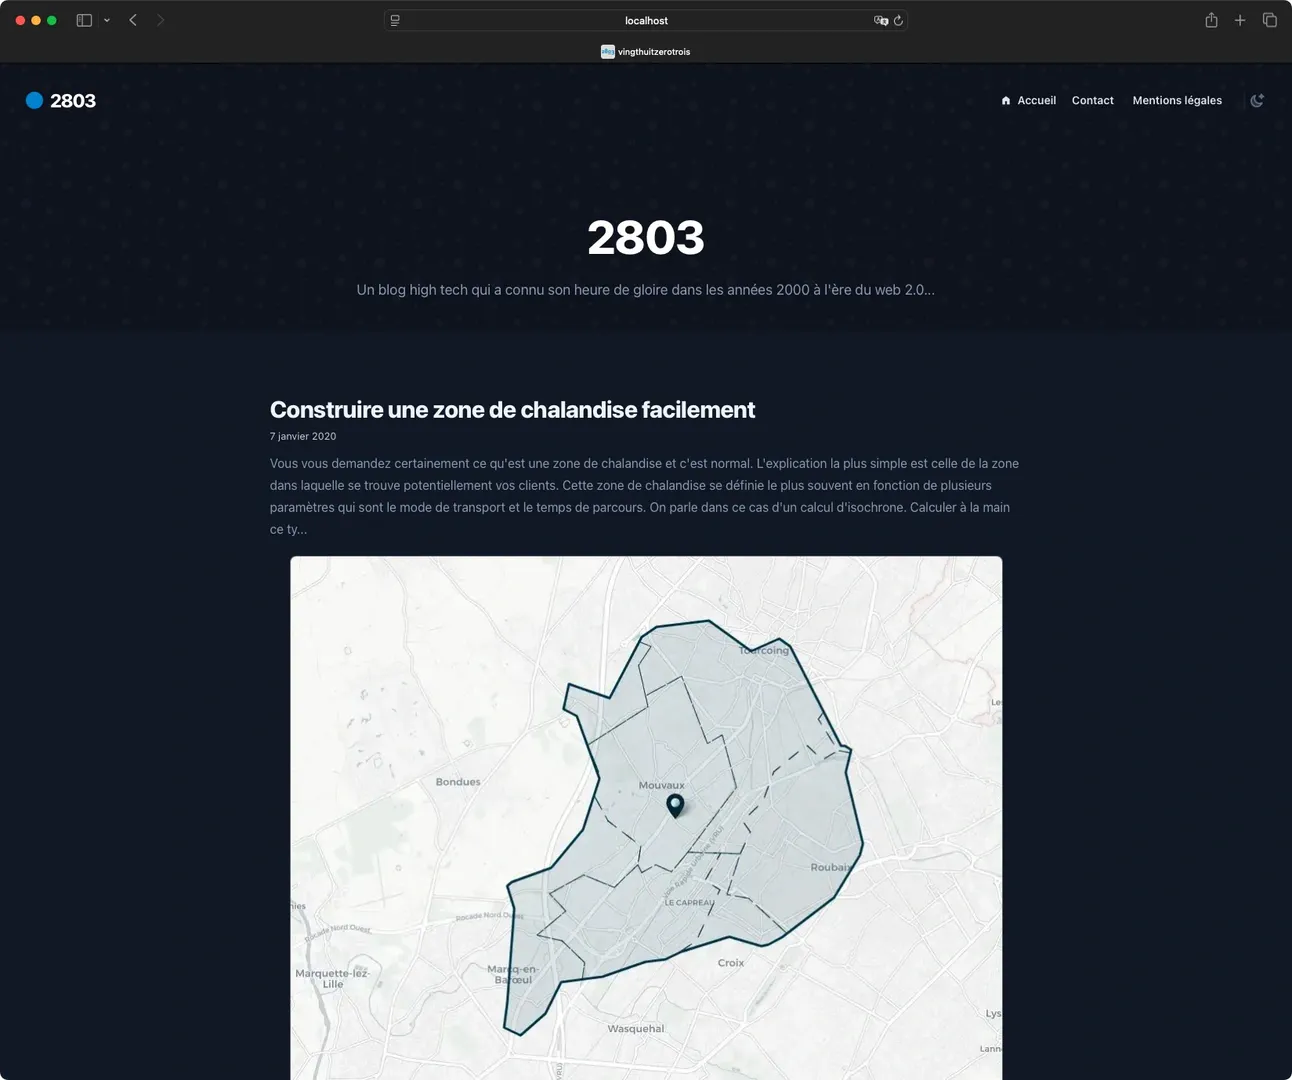
Depuis quelques mois je m'amuse beaucoup avec Nextjs et donc je me suis pourquoi pas passer ces vieux blogs sous Nextjs, une sacrée mise à jour pour des blogs datant de 2005 pour 2803.fr. Voilà donc le résultat, certes je n'ai pas toutes les fonctionnalités de Wordpress (plus de commentaires, de gestion des liens des tags et catégories, feed...) mais c'était l'objectif. Ce qui est étonnant (enfin logique) c'est que finalement ces blogs sont maintenant plus rapides, plus jolis et plus faciles à maintenir, la magie de Nextjs.
Pour ceux que cela intéresse de migrer aussi des blogs wordpress vers Nextjs je vais vous expliquer rapidement comment faire cela, si vous connaissez un peu Nextjs je dirais presque que cela est facile ;)
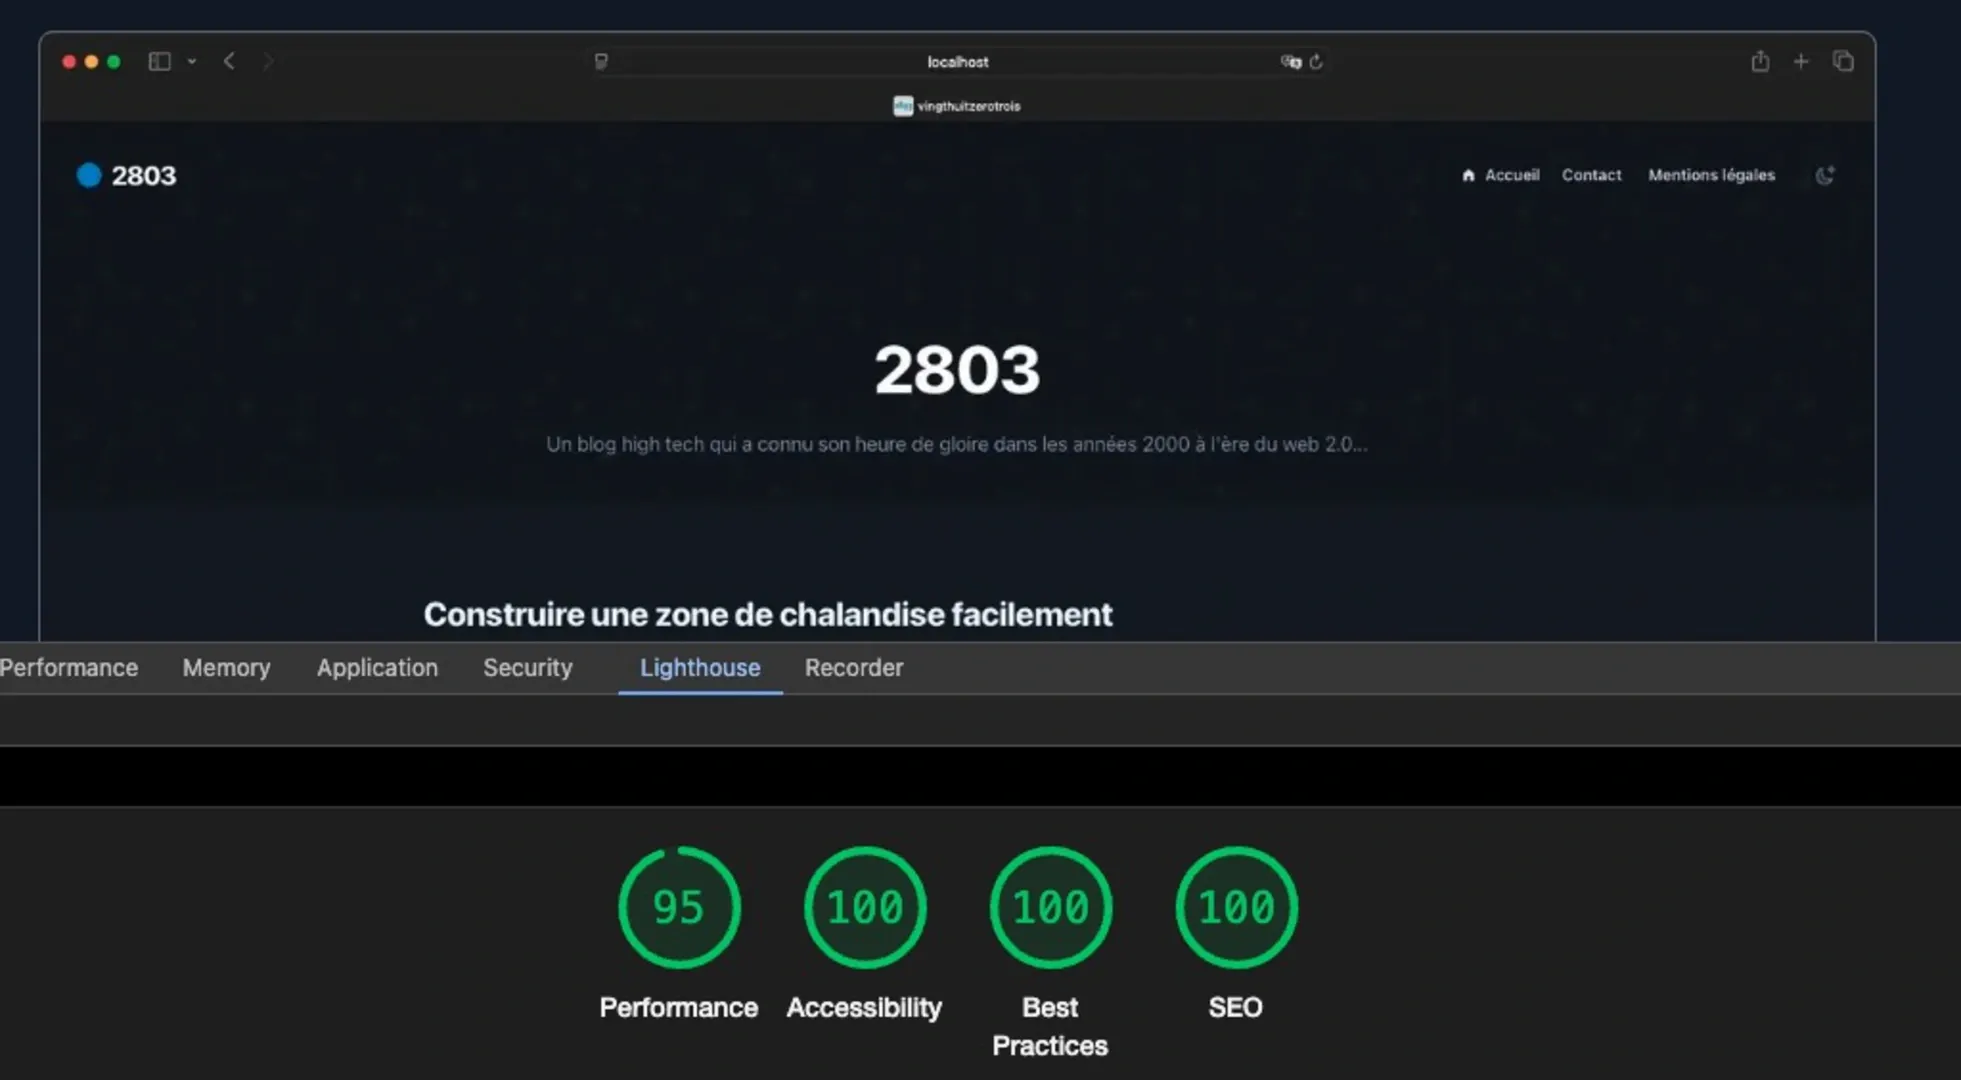
A la fin on arrive à cela :
Donc on y va pour un tutoriel certainement incomplet et trop rapide mais vous aurez la logique et le principe de base.
Les prérequis
- Un blog wordpress logique !
- Un compte sur github c'est mieux comme cela vous pouvez aussi faire du versionning et développer en local sur votre machine
- Un peu de connaissance de Nextjs (sinon chatgpt ou claude seront vos meilleurs amis)
- Connaître markdown aussi, ce qui est fou c'est que je découvre markdown avec cette migration et c'est canon, cet article est par ailleurs écrit avec Markdown c'est pour dire
- Et un peu de motivation quand même car tout n'est pas si facile que cela
Téléchargement des données du blog
- C'est à la porté de tous il suffit d'utiliser l'outil intégrér de Wordpress pour faire cela et avoir un joli XML bien complet comme il faut. (/outils/exporter)
Nettoyage du XML
- J'ai eu plein de soucis avec ce XML qui était complet mais par exemple j'avais les liens vers les images resizées et pas vers les images originales que je voulais réutiliser pour cette nouvelle version notamment pour les convertir en webp, les resizer au nouveau format, etc... Bref j'ai du faire un peu de nettoyage du XML pour ne garder que les données qui m'intéressaient.
- Plutôt que de faire cela à la main j'ai donc avec mes amis GPT fait un petit script python pour nettoyer le XML d'origine de Wordpress, ce script va donc remplacer les liens vers les images resizées par les liens vers les images originales, supprimer les dimensions des images dans les liens, etc...
- Voilà le script python que j'ai utilisé pour nettoyer le XML d'origine de Wordpress et franchement il fonctionne pas mal du tout :
import re
import xml.etree.ElementTree as ET

# Fonction pour supprimer les dimensions des URLs d'images
def remove_image_dimensions(content):
    # Si le contenu est None, on retourne None
    if content is None:
        return content
    # Regex pour repérer les dimensions du type -500x261 dans les URLs d'images
    pattern = re.compile(r'-\d+x\d+(?=\.\w{3,4})')
    return pattern.sub('', content)

# Fonction pour traiter un fichier XML
def process_xml_file(input_file, output_file):
    try:
        tree = ET.parse(input_file)
        root = tree.getroot()
    except ET.ParseError as e:
        print(f"Erreur de parsing : {e}")
        return

    for elem in root.iter():
        if elem.tag.endswith('encoded'):
            if elem.text is not None:
                modified_content = remove_image_dimensions(elem.text)
                elem.text = modified_content

    tree.write(output_file, encoding='utf-8', xml_declaration=True)
    print(f"Fichier traité et sauvegardé sous : {output_file}")

# Main
if __name__ == "__main__":
    # Nom du fichier XML d'entrée
    input_file = 'blogdcodesign.WordPress.2024-09-23.xml'
    # Nom du fichier XML de sortie
    output_file = 'blogdecodesign.xml'

    # Traiter le fichier XML
    process_xml_file(input_file, output_file)

    print(f"Fichier traité et sauvegardé sous : {output_file}")
Convertion en markdown et téléchargement des images
- Maintenant que le XML avait les bons liens vers les images originales j'ai pu utiliser le npx de Will Boyd et c'est canon car très bien fait et efficace!
- Vous avez dans la console un pas à pas qui vous demande l'emplacement du XML et le dossier de destination pour les fichiers markdown et les images et après il bosse en convertissant le XML en markdown et en téléchargeant les images.
Nettoyage du markdown et conversion des images en webp avec un resize
- Encore un script python pour nettoyer le markdown qui est pas mal mais avec quelques corrections à apporter pour un usage dans nextjs.
- En effet les liens des images qui ont été générés par le script avec le format (images/monimage.jpg) et il me fallait dans nextjs un format comme cela (/images/monimage.jpg) pour que les images soient bien chargées.
- Aussi j'avais des liens sur les images vers des pages d'attachement ça ne me servait à rien donc j'ai supprimé ces liens.
- Bon dans Nextjs on devait oublier les iframes et donc les videos youtube embeded. Habituellement je mettais le lien uniquement et Wordpress faisait l'intégaration là il a fallut chercher et donc afficher la vignette de la video et le lien vers la video youtube. C'était la seule solution posssible. Le script intégrer cela aussi.
- Et enfin j'ai ajouté un script pour convertir les images en webp et les resizer au nouveau format.
import os
import re
import shutil
from pathlib import Path
from PIL import Image
import html
def convert_to_webp(image_path, output_dir):
try:
with Image.open(image_path) as img:
webp_path = output_dir / (image_path.stem + '.webp')
img.save(webp_path, 'WEBP')
return webp_path
except Exception as e:
print(f"Erreur lors de la conversion de {image_path}: {e}")
new_path = output_dir / image_path.name
shutil.copy(image_path, new_path)
return new_path
def convert_code_blocks(content):
pattern = r'\\\[php\\\](.*?)\\\[/php\\\]'
replacement = r'```php\n\1\n```'
return re.sub(pattern, replacement, content, flags=re.DOTALL)
def convert_html_entities(content):
return html.unescape(content)
def remove_image_links(content):
# Ajout d'un texte alternatif par défaut
default_alt_text = "Image"
pattern = r'\[!\[(.*?)\]\((.*?)\)\]\((.*?)\)'
replacement = r'' # Conserve l'original alt text si présent
content = re.sub(pattern, replacement, content)
# Ajouter le texte alternatif par défaut aux images sans texte alternatif
content = re.sub(r'!\[\]\((.*?)\)', f'', content)
return content
def process_markdown_file(file_path, images_dir, output_dir):
with open(file_path, 'r', encoding='utf-8') as file:
content = file.read()
# Convertir les blocs de code PHP
content = convert_code_blocks(content)
# Convertir les entités HTML
content = convert_html_entities(content)
def replace_image(match):
alt_text = match.group(1)
image_path = match.group(2)
title = match.group(3) or '' # Utilisez une chaîne vide si pas de titre
image_path = Path(image_path)
if not image_path.is_absolute():
image_path = Path(file_path).parent / image_path
try:
new_image_path = convert_to_webp(image_path, output_dir)
new_image_name = new_image_path.name
if title:
return f''
else:
return f''
except Exception as e:
print(f"Erreur lors du traitement de l'image {image_path}: {e}")
return match.group(0) # Retourne l'image originale en cas d'erreur
# Remplacer les images par des images WebP
content = re.sub(r'!\[(.*?)\]\((.*?)(?:\s+"(.*?)")?\)', replace_image, content)
# Supprimer les liens autour des images
content = remove_image_links(content)
# Traitement des liens YouTube
def replace_youtube_link(match):
url = match.group(0)
video_id = re.search(r'v=([\w-]+)', url).group(1)
return f'[]({url})'
youtube_pattern = r'https?://(?:www\.)?youtube\.com/watch\?(?:[^&]+&)*v=([\w-]+)(?:&[^&]+)*'
content = re.sub(youtube_pattern, replace_youtube_link, content)
# Écrire le contenu modifié dans le fichier
with open(file_path, 'w', encoding='utf-8') as file:
file.write(content)
def main(markdown_dir, images_dir, output_dir):
output_dir = Path(output_dir)
output_dir.mkdir(parents=True, exist_ok=True)
for root, _, files in os.walk(markdown_dir):
for file in files:
if file.endswith('.md'):
file_path = Path(root) / file
process_markdown_file(file_path, images_dir, output_dir)
if __name__ == "__main__":
dossier_markdown = '/Users/henrilabarre/Downloads/blogdecodesign'
images_dir = '/images/posts'
output_dir = '/Users/henrilabarre/Downloads/blogdecodesign/images/webp'
main(dossier_markdown, images_dir, output_dir)
Puis intégration dans Nextjs
- A ce stade on avait donc les fichiers markdown et les images au format webp, restait donc à mettre cela dans Nextjs.
- Je ne vais pas rentrer dans les détails dans cet article, cela sera peut être un nouvel article mais j'ai du faire cela pour que cela fonctionne correctement:
- Un composant pour utiliser le composant natif
<Image>de Nextjs - Filtrer le contenu pour afficher la première image dans les pages paginées d'articles
- Filtrer le contenu enlever les balises wordpress qui n'avaient pas été enlevées comme les ...
Les modules npm utilisés pour faire toutes ces manipulations de HTML sont (et oui cela en fait en fait), pour information j'en ai testé des dizaines, c'était un peu la partie pénible du travail :
    "gray-matter": "^4.0.3",
    "html-react-parser": "^5.1.16",
    "image-size": "^1.1.1",
    "jsdom": "^25.0.1",
    "remark": "^15.0.1",
    "remark-html": "^16.0.1",
    "remove-markdown": "^0.5.5",
Et voilà en plus avec Nextjs on gère aussi les dark et light theme et cela je suis fan depuis longtemps mais je passais beaucoup trop de temps à l'intégrer proprement.
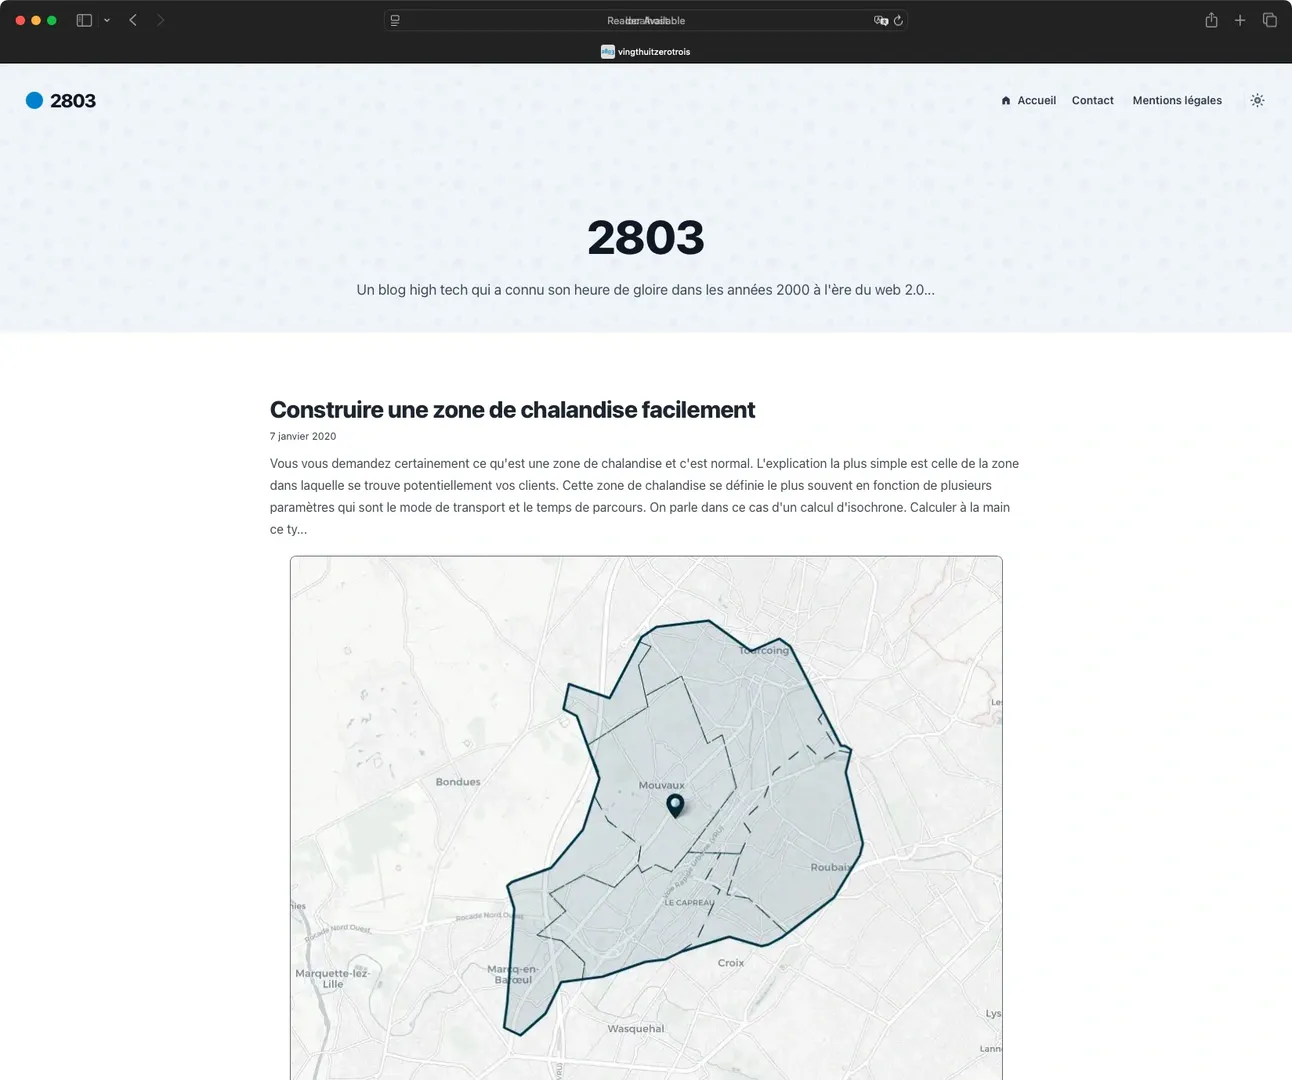
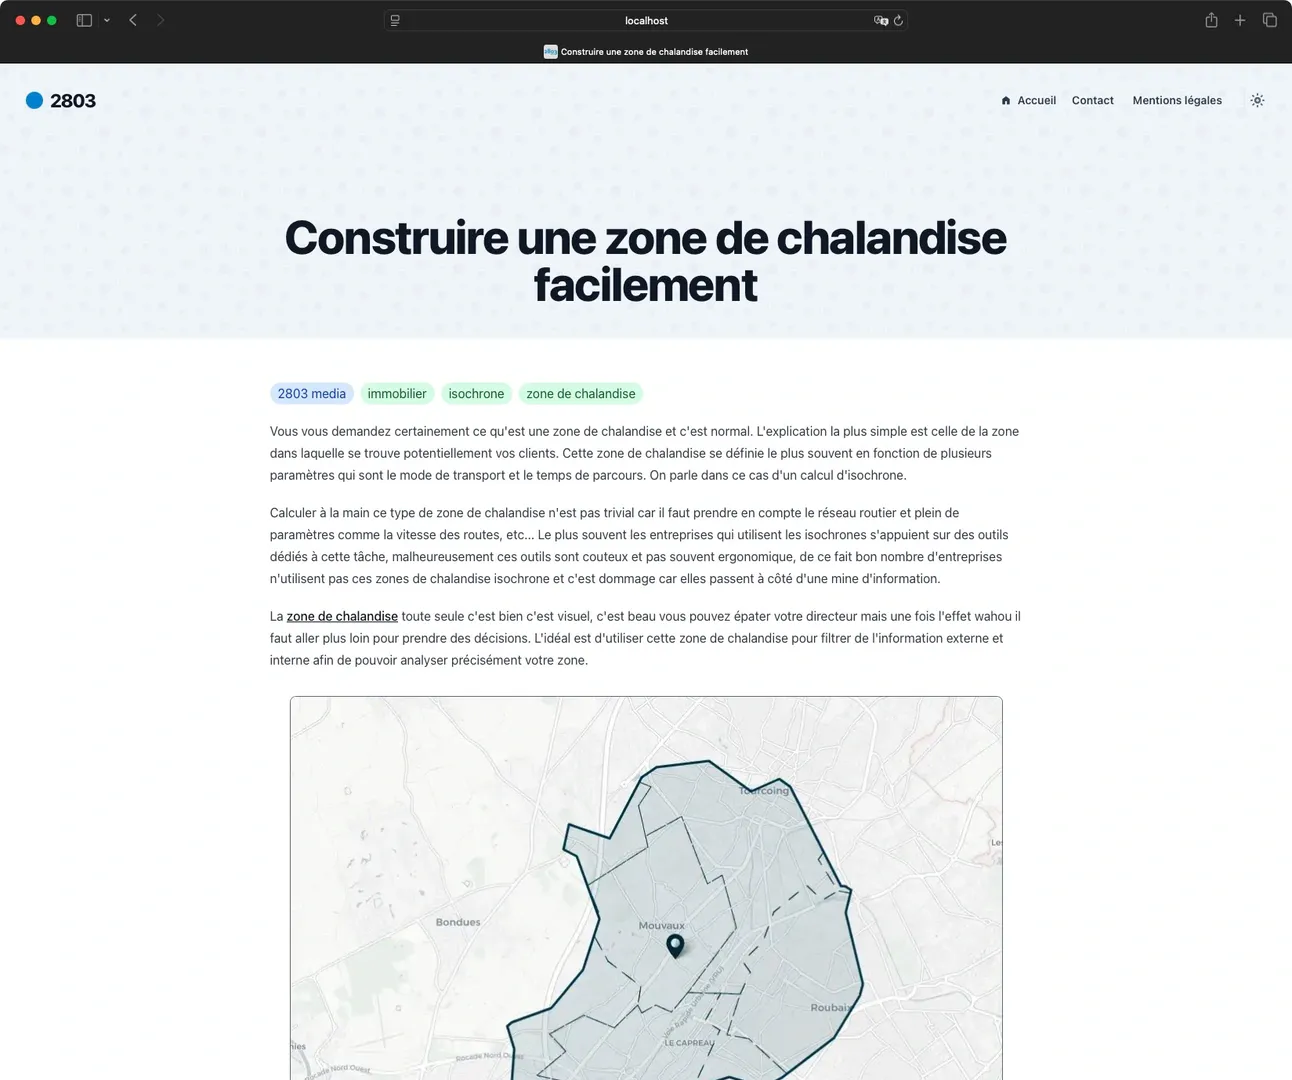
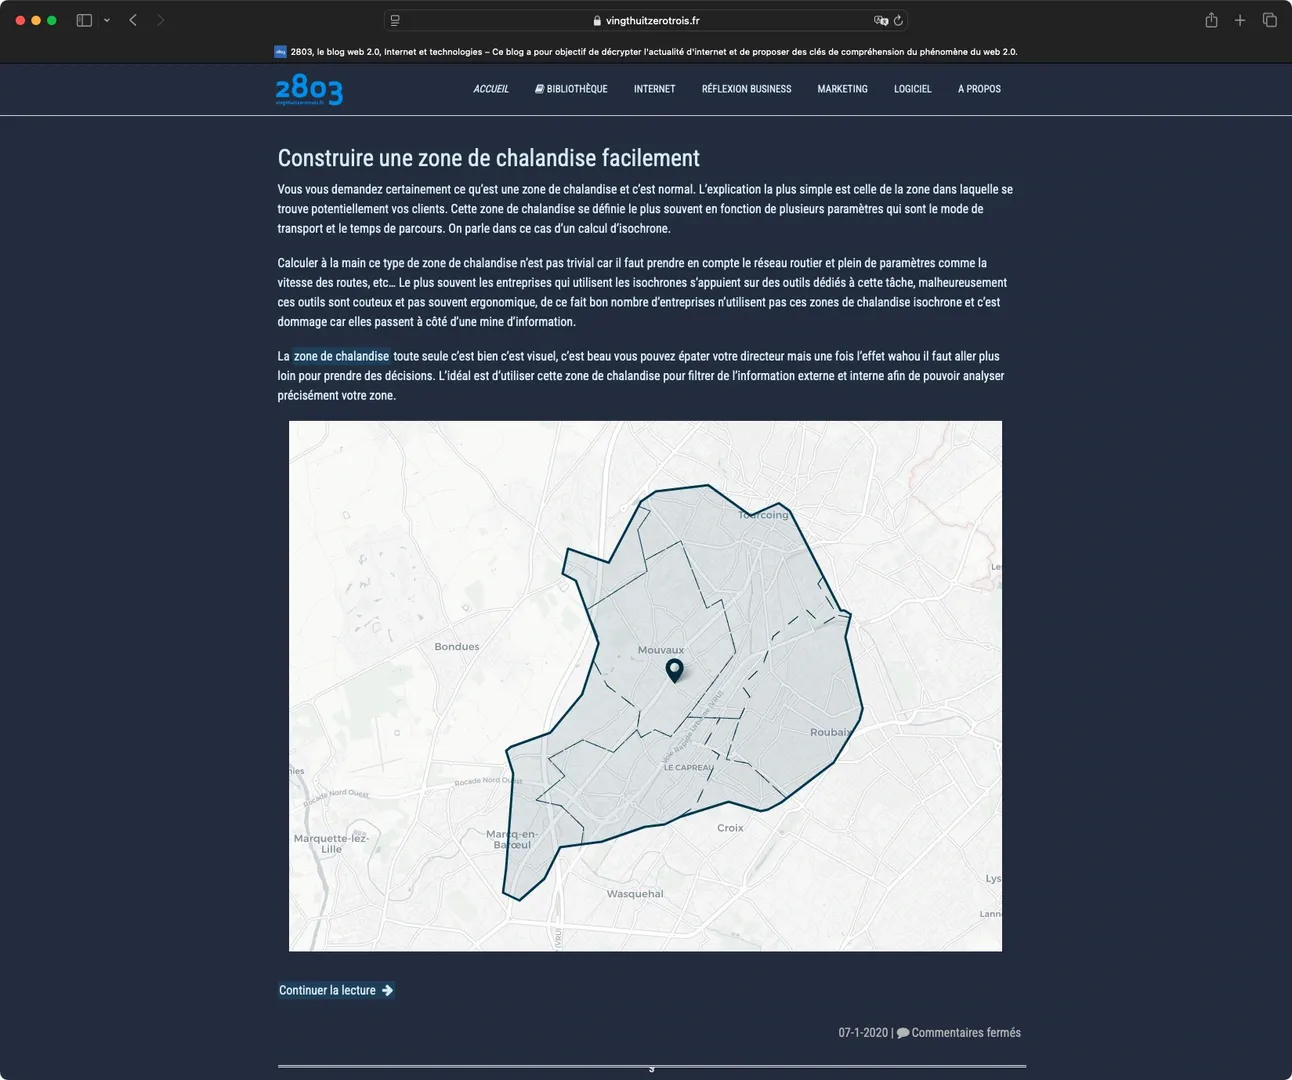
Pour mémoire on partait de cela:
Bonne migration si vous tentez l'aventure, mais c'est gérable et 100% bénéfique car maintenant je n'ai plus de :
- Plugins à mettre à jour
- Thème à mettre à jour
- Problème de compatibilité
- Mise à jour de Wordpress
- D'intrusions de bots
- De problème de sécurité
Et je peux continuer à écrire sans installer de plugin pour ne pas à avoir à utiliser Guttemberg ;) Et cerise sur le gâteau ça va plus vite et c'est bon pour le SEO!
Publié le